Table of Contents
KI-Systeme wirken neutral: Sie rechnen, sie haben keine Laune und keine Vorlieben. Trotzdem liefern sie regelmäßig Ergebnisse, die einseitig sind – manchmal offensichtlich, häufiger unauffällig. Der Grund dafür heißt Bias: eine systematische Verzerrung, die sich durch die Daten, die Modellentwicklung oder die Nutzung in ein System einschleicht. Wer KI im Unternehmen einsetzt, sollte wissen, wo solche Verzerrungen entstehen und woran sie sich erkennen lassen.
Was mit Bias gemeint ist
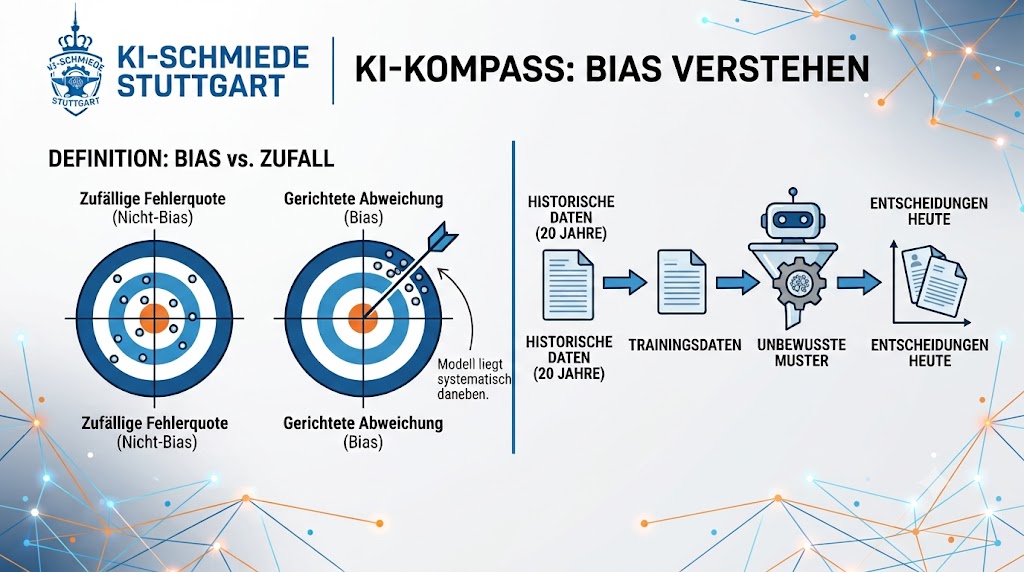
Ein Bias ist keine zufällige Fehlerquote, sondern eine gerichtete Abweichung. Ein Modell liegt also nicht mal zu hoch und mal zu niedrig, sondern systematisch in eine bestimmte Richtung daneben. Ein Beispiel: Ein System zur Vorauswahl von Bewerbungen, das mit Einstellungsentscheidungen der letzten zwanzig Jahre trainiert wurde, übernimmt die Muster dieser Entscheidungen – einschließlich der Muster, die niemand bewusst festgelegt hat.
Wichtig dabei: Das Modell „will“ nichts. Es reproduziert Regelmäßigkeiten, die in den Trainingsdaten stecken. Ein Bias ist deshalb selten böse Absicht und fast immer ein Abbild von etwas, das bereits vorher da war.
Wo Verzerrungen entstehen
In den Daten. Die häufigste Quelle. Sind bestimmte Gruppen, Regionen, Sprachen oder Fälle in den Trainingsdaten unterrepräsentiert, funktioniert das Modell für sie schlechter. Ein Spracherkennungssystem, das überwiegend mit Standardaussprache trainiert wurde, versteht Dialekte schlechter – nicht weil Dialekt schwerer zu verstehen wäre, sondern weil er im Training kaum vorkam.
In der Zielsetzung. Was ein Modell optimieren soll, ist eine Entscheidung. Ein System, das auf „möglichst wenige Fehlalarme“ getrimmt wird, übersieht dafür mehr echte Fälle. Diese Abwägung ist unvermeidbar, wird aber oft nicht bewusst getroffen.
In der Aufbereitung. Wie Daten bereinigt, kategorisiert und beschriftet werden, prägt das Ergebnis. Wer beim Beschriften unklare Fälle konsequent einer Kategorie zuordnet, verschiebt damit die spätere Verteilung.
In der Nutzung. Auch die Fragestellung erzeugt Verzerrung. Eine suggestiv formulierte Anfrage führt zu einer Antwort, die die Suggestion aufgreift. Sprachmodelle neigen dazu, der im Prompt angelegten Richtung zu folgen.
Warum das im Alltag relevant ist
In vielen Anwendungsfällen fällt ein Bias kaum ins Gewicht. Wenn eine KI einen Text kürzt oder eine Mail formuliert, ist eine leichte Schlagseite meist folgenlos. Kritisch wird es dort, wo Entscheidungen über Menschen oder Geld getroffen werden: bei der Vorauswahl von Bewerbungen, bei Bonitätseinschätzungen, bei der Priorisierung von Kundenanfragen oder bei automatisierten Preisempfehlungen.
Das eigentliche Problem ist dabei nicht der Fehler selbst, sondern seine Unsichtbarkeit. Eine verzerrte Ausgabe sieht genauso aus wie eine korrekte – gut formuliert, plausibel, ohne Warnhinweis. Wer die Ergebnisse nicht gezielt prüft, bemerkt die Schieflage oft erst, wenn sie sich über viele Fälle summiert hat.
Woran sich Verzerrungen erkennen lassen
Ein vollständiger Test ist im Alltag nicht leistbar, ein paar einfache Prüfungen aber schon:
- Gegenprobe mit vertauschten Merkmalen: Dieselbe Anfrage mit verändertem Namen, Geschlecht, Wohnort oder Firmengröße stellen und die Antworten vergleichen.
- Randfälle testen: Nicht nur typische Fälle prüfen, sondern gezielt untypische – dort zeigen sich Lücken in den Trainingsdaten zuerst.
- Ergebnisse über die Zeit auswerten: Wenn ein System eine Vorauswahl trifft, lohnt sich der regelmäßige Blick auf die Verteilung der Ergebnisse.
- Fragestellung neutral formulieren: Prompts prüfen, ob sie eine Antwortrichtung bereits vorgeben.
Was sich dagegen tun lässt
Bias vollständig zu beseitigen ist nicht möglich – jede Datengrundlage ist ein Ausschnitt der Wirklichkeit. Sinnvoll ist stattdessen ein bewusster Umgang: Bei Entscheidungen mit Auswirkung auf Menschen sollte KI vorbereiten, nicht entscheiden. Kriterien sollten dokumentiert und nachvollziehbar sein. Und es sollte definiert sein, wer Ergebnisse prüft und wie eine Fehlentscheidung korrigiert wird.
Hilfreich ist außerdem, den Einsatzbereich eng zu fassen. Ein Modell, das für eine klar umrissene Aufgabe mit passenden Daten eingesetzt wird, ist leichter zu kontrollieren als eines, das breit und unspezifisch verwendet wird.
Fazit
Biases sind kein Sonderfall, sondern eine normale Eigenschaft von Systemen, die aus Daten lernen. Für Unternehmen bedeutet das nicht, auf KI zu verzichten, sondern sie dort einzusetzen, wo sich Ergebnisse überprüfen lassen – und dort besonders genau hinzuschauen, wo Entscheidungen Menschen betreffen. Ein realistischer Blick auf die Grenzen ist dabei kein Hindernis, sondern die Voraussetzung dafür, dass die Ergebnisse verlässlich bleiben.
Folge uns auf:
Weitere Beiträge
KI-Agenten überlasten die IT: Warum strukturierte Einführung entscheidend ist
GEO & Personal Memory: Wenn das KI-Gedächtnis die Suche verändert